
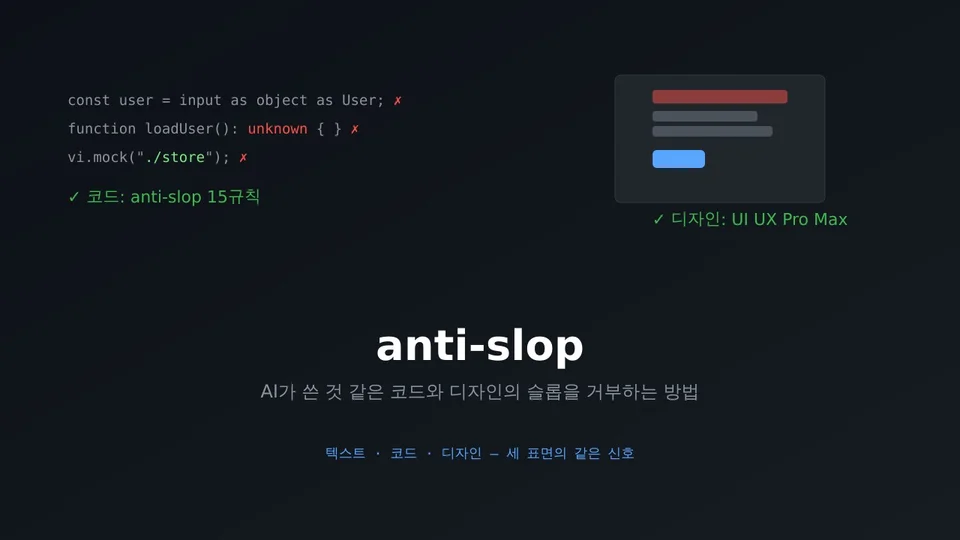
AI 코딩 에이전트가 만든 것 같은 "슬롭(slop)"을 거부하는 방법. 코드는 anti-slop(15개 Oxlint 규칙, 1,371★)이 unknown/단언/모킹을 거부하고, 디자인은 UI UX Pro Max(38,100★)가 통계적 평균 스타일을 대체한다. 텍스트·코드·디자인을 아우르는 슬롭 방어선.
핵심 요약
- anti-slop은 AI 코딩 에이전트가 만든 것 같은, 증거가 부족하고 신호가 없는 TypeScript·JavaScript 코드 패턴을 Oxlint 린트 단계에서 거부하는 규칙 모음입니다 (GitHub).
- 2026-08-12 생성, 8-14 최종 push로 공개 이틀 만에 1,371★ / 포크 22를 기록했습니다. 라이선스는 MIT, 언어는 TypeScript입니다 (GitHub).
- 핵심 규칙은 15개이며 전부
error수준으로 기본 활성화됩니다:no-chained-type-assertions,no-module-mocking,no-unknown-returns,no-unsafe-dictionary-type,require-safety-comment-for-type-assertion등 (GitHub). - 철학은 하나로 요약됩니다. 타입 시스템이 증거를 만들게 하고,
unknown/any/object같은 넓은 타입에 의존하는 코드를 거부한다. 넓은 타입은 AI가 급조한 신호 없는 코드의 가장 흔한 지문입니다 (GitHub). - npm 의존성이 아니라 vendored 방식을 권장합니다. 코드를 복사해 팀 기준에 맞게 수정해서 쓰는 방식이라, 팀 표준으로 끌어올리기 좋습니다 (GitHub).
- 이 철학은 텍스트 영역의 'AI 티 감지'와 정확히 평행합니다. 글 품질 검사가 상투어·수사 습관을 거부하듯, anti-slop은 unknown·단언·모킹 같은 코드 패턴을 거부합니다. 둘 다 'AI가 만들었다'를 증명하는 게 아니라, 증거 없는 산출물의 신호를 자동으로 거부합니다.
- 이 방어선은 코드와 텍스트에만 있지 않습니다. 디자인에도 AI 슬롭이 있습니다. AI가 만든 랜딩 페이지가 똑같아 보이는 이유는 학습 데이터의 통계적 평균을 샘플링하기 때문이며, UI UX Pro Max(38,100★) 같은 도구가 그 평균에서 벗어나도록 디자인 컨텍스트를 주입합니다 (UI UX Pro Max).
AI 코드의 '슬롭'이란 무엇인가
anti-slop은 AI 생성 코드의 대표적 신호 — 넓은 타입 의존과 안전 확인 없는 단언, 의존성 회피용 모킹 — 를 컴파일 전 린트 단계에서 거부하는 린트 도구입니다. 이 정의가 이 글의 출발점입니다.
코딩 에이전트를 써 본 사람이라면 비슷한 벽을 만납니다. 에이전트가 작성한 코드가 컴파일은 되는데, 막상 읽으면 '이게 왜 이렇게 됐지' 하는 순간이 옵니다. 타입은 전부 unknown이고, 안전 확인 없이 단언으로 넘기고, 테스트는 전부 모킹으로 회피한 코드. 동작은 하지만, 그 코드를 만든 주체가 '무엇을 알고 있는지'가 전혀 드러나지 않는 코드입니다.
anti-slop은 바로 여기에 이름을 붙입니다. 슬롭(slop) — 증거가 없고 신호가 없는 산출물. 텍스트에서 'AI가 쓴 것 같은 글'이 반복되는 상투어와 수사 습관으로 드러난다면, 코드에서 'AI가 쓴 것 같은 코드'는 넓은 타입과 안전 확인 없는 단언, 그리고 의존성 회피용 모킹으로 드러납니다.
정의를 고정하겠습니다. anti-slop은 AI 생성 코드의 대표적 신호 — 즉 넓은 타입 의존과 증거 위조 — 를 컴파일 전의 린트 단계에서 자동으로 거부하는 Oxlint 규칙 모음입니다 (GitHub). 만들어진 건 2026년 8월이지만, 문제 자체는 코딩 에이전트가 일상화된 순간부터 존재해 왔습니다.
왜 린트로 거부하는가: 타입이 곧 증거
anti-slop의 출발점은 단순한 관찰입니다. TypeScript 타입 시스템은 코드가 '무엇을 알고 있는가'를 적는 장치인데, AI 코드는 이 장치를 무력화하는 경향이 있다. 모든 것을 unknown으로 받고, 안전 확인 없이 단언으로 좁히고, 함수 반환을 unknown으로 던져 버립니다. 이건 증거를 만들지 않는 코딩입니다.
대표 규칙 몇 개를 보면 철학이 바로 드러납니다 (GitHub).
// no-chained-type-assertions — 중첩 단언은 증거를 위조한다
const user = input as object as User;

// no-unknown-returns — 계약이 unknown을 반환하면 안 된다
function loadUser(): unknown {
  return input;
}

// no-module-mocking — 모킹 대신 실제 의존성 seam을 쓰라
vi.mock("./user-store");

// no-unsafe-dictionary-type — 사전 값은 unknown이면 안 된다
type Metadata = Record<string, unknown>;

// require-safety-comment-for-type-assertion — 단언마다 안전 이유를 적으라
const userId = value as UserId;
각 규칙은 같은 메시지를 다른 각도로 반복합니다. no-chained-type-assertions는 object를 거쳐 User로 좁히는 단언이 그 사이에 아무런 검증도 없음을 지적하고, no-unknown-returns는 함수가 반환 계약을 unknown으로 세우면 호출부가 다시 단언에 의존하게 됨을 막고, require-safety-comment-for-type-assertion은 단언을 쓸 거라면 그 단언이 지키는 불변식을 주석으로 남기라고 요구합니다.
여기서 주목할 점은 이 규칙들이 '옳은 코드'를 강제하는 게 아니라 '증거 없는 코드'를 골라내는 데 집중한다는 것입니다. unknown은 때로 정당합니다. 외부 API 경계처럼 런타임에 형태를 알 수 없는 입력이 바로 그 경우입니다. anti-slop은 그런 정당한 쓰임을 지우는 게 아니라, 에이전트가 편의를 위해 무분별하게 넓은 타입을 쓰는 습관을 잡습니다 (GitHub).
텍스트의 슬롭과 코드의 슬롭은 같은 문제다
이 규칙들의 의도가 가장 선명하게 드러나는 대목은, 텍스트 영역에서 이미 검증된 'AI 티 감지'와의 평행성입니다. 콘텐츠 품질 검사는 AI가 쓴 것 같은 글의 반복 패턴 — "주목받고 있습니다", "핵심을 짚어보면", 일정한 문단 리듬 — 을 수치로 세고 거부합니다. anti-slop은 코드에 똑같은 일을 합니다. unknown 반환, 연쇄 단언, 모킹 회피는 코드 세계의 '상투어'입니다.
공통점은 더 깊습니다. 둘 다 '이 산출물이 AI가 만들었다'를 증명하려 하지 않습니다. 그런 증명은 어차피 불가능에 가깝습니다. 대신 둘 다 증거 없는 산출물의 신호 패턴을 자동으로 잡아내고, 그 패턴이 반복될 때 거부합니다. 글 게이트가 "반복 문단이 N개, 상투 표현이 M회"를 세는 것처럼, anti-slop은 "타입 단언이 몇 번, unknown 반환이 몇 번"을 세는 대신 더 강하게 — 아예 에러로 — 처리합니다.
이 평행성은 우연이 아닙니다. AI가 텍스트를 쓸 때 일정한 리듬에 빠지는 것과, 코드를 쓸 때 넓은 타입에 기대는 것은 같은 근본 원인의 두 얼굴입니다. 모델이 '충분히 정확해 보이는' 산출물을 빠르게 내놓는 과정에서, 검증 가능한 근거를 생략하는 습관 말입니다. 그래서 anti-slop은 단순한 린트 플러그인이 아니라, 에이전트 산출물에 대한 방어선이 어디에 서야 하는지 보여주는 사례가 됩니다.
디자인에도 슬롭이 있다: 같은 신호, 다른 표면
방어선을 코드와 텍스트에만 한정하면 절반만 보는 셈입니다. AI 슬롭은 세 번째 표면 — 디자인 — 에서도 똑같이 나타납니다. 그리고 원인은 코드 슬롭과 완전히 같습니다.
왜 AI가 만든 랜딩 페이지는 전부 비슷한가
AI 디자인 도구로 만든 랜딩 페이지를 여러 개 보면 패턴이 반복됩니다. 같은 그라디언트 배경, 같은 둥근 카드, 같은 폰트 조합, 같은 '이미지 + 제목 + 버튼' 배열. 이게 우연이 아닙니다. AI는 학습 데이터의 통계적 평균을 샘플링하므로, 가장 흔한 조합을 가장 자연스럽게 골라냅니다 (dev.to). 코드에서 unknown을 가장 쉽게 쓰는 것과 같은 메커니즘입니다. 모델은 '무엇이 평균인가'를 알지, '무엇이 이 제품에 맞는가'를 모릅니다.
이 문제를 해결하는 대표 도구가 UI UX Pro Max입니다 (GitHub). AI 스킬 형태로 제공되며, 50개 이상의 디자인 스타일, 97가지 색상 팔레트 조합, 57가지 폰트 페어링, 그리고 160개 이상의 제품 유형별 추론 규칙을 담고 있습니다. 사용자가 "SaaS 랜딩 페이지"라고만 말하면, AI가 평균적인 랜딩 페이지를 만드는 대신 그 제품 유형에 맞는 전문 스타일을 고르도록 디자인 컨텍스트를 주입합니다.
코드 슬롭과 같은 구조
디자인 슬롭 방어는 코드 슬롭 방어와 구조적으로 동일합니다.
- 코드:
unknown/any/object같은 넓은 타입 → anti-slop이 에러로 거부 - 텍스트: 상투어·수사 습관 → 품질 검사가 수치로 거부
- 디자인: 통계적 평균 스타일 → UI UX Pro Max 같은 도구가 전문 컨텍스트로 대체
세 경우 모두 같은 원칙이 깔립니다. '안전한 기본값'에 머무르는 것을 거부하고, 산출물이 증거(타입 / 출처 / 제품 맥락)에 근거하도록 강제한다. 코드에서는 타입이 증거였고, 디자인에서는 '이 제품이 어떤 사용자를 위한 것인가'가 증거입니다.
디자인 슬롭을 잡는 또 다른 방식
검출 측면도 있습니다. slop-detect는 16개 규칙의 'AI 디자인 슬롭 지문'으로 랜딩 페이지를 점수화하고, Cursor·v0·Lovable 같은 AI 빌더의 템플릿 흔적을 감지합니다 (GitHub). anti-slop이 '증거 없는 코드'를 린트로 거부한다면, slop-detect는 '평균적인 디자인'을 스코어로 점수화합니다. 방어의 방향은 같고 적용 표면만 다른 것입니다.
실용 관점: 어디까지 켜야 하는가
균형도 분명히 짚어야 합니다. 15개 규칙을 전부 error로 켜는 건 팀에 따라 과할 수 있습니다 (GitHub).
- 너무 엄격하면 오버엔지니어링과 개발 속도 저하가 옵니다. 모든 단언에 안전 주석을 요구하는 규칙은, 검증이 오히려 방해가 되는 단순한 코드에서는 생산성을 떨어뜨립니다.
unknown은 때로 정답입니다. 외부 입력 경계, 파서, 알 수 없는 API 응답 같은 곳에서는 넓은 타입이 오히려 정직한 표현입니다. 이걸 전부 금지하면 거짓 양성이 쌓입니다.- 이 프로젝트는 그래서 vendored 방식을 택했습니다. npm 패키지로 고정하지 않고 코드를 복사해 팀 기준에 맞게 수정하라고 권장합니다. 규칙을 켜고 끄고, 예외를 추가하는 게 패키지 갱신과 분리되도록 말입니다 (GitHub).
도입을 고민한다면, 전체를 한 번에 켜기보다 낮은 단계부터 시작하는 편이 안전합니다. 아래 체크리스트를 참고하시기 바랍니다.
- 1단계 — 증거 위조부터 잡는다.
no-chained-type-assertions,no-widen-then-assert처럼 '타입을 속이는' 규칙부터 켭니다. 이건 논쟁이 적고 즉시 효과가 있습니다. - 2단계 — 모킹 회피를 단속합니다.
no-module-mocking을 켜 테스트가 실제 의존성 seam을 쓰게 유도합니다. - 3단계 — unknown 계약을 정리합니다.
no-unknown-returns,no-unknown-parameters,no-unsafe-dictionary-type을 팀 규칙으로 합의한 뒤 켭니다. - 4단계 — 안전 주석을 요구합니다.
require-safety-comment-for-type-assertion은 마지막에 켭니다. 여기까지 오면 팀이 이미 단언의 의미를 논의하는 단계라 부담이 적습니다. - 5단계 — 예외를 명문화합니다. 외부 입력 경계처럼
unknown이 정당한 위치를 코드로 문서화하고, 그 위치만 허용합니다.
핵심은 이 규칙들이 절대값이 아니라 팀이 에이전트 코드를 어떻게 대할지 정하는 기준이라는 것입니다. 전부 켜는 게 목표가 아니라, '증거 없는 코드'를 자연스럽게 거부하는 문화를 만드는 게 목표입니다. anti-slop은 그 문화의 린트 버전일 뿐입니다.