
Column
자가진화의 두 방식 — 스킬을 진화시키는 SkillProx, 에이전트를 진화시키는 Ouroboros
AI 에이전트 자가진화는 두 가지 방식으로 연구된다. 지식을 진화시키는 SkillProx와 에이전트 자신을 진화시키는 Ouroboros를 실측 수치로 비교합니다.

핵심 요약
- AI 에이전트의 자가진화(self-evolution)는 두 가지 방식으로 연구되고 있습니다: 지식을 진화시키는 방식(SkillProx)과 에이전트 자신을 진화시키는 방식(Ouroboros)
- SkillProx(arXiv:2608.07449): 스킬(지식)을 진화 대상으로 삼아, 실험실 벤치마크 점수로 검증 → 닫힌 루프 검증으로 54.5% 달성
- Ouroboros(arXiv:2608.08311): 에이전트의 도구·프롬프트·코어 구현을 리뷰된 커밋으로 개선 → 그 커밋이 다음 작업의 런타임이 됨. 161일간 실제 배포로 검증
- SkillProx는 "무엇을 아는가" 를, Ouroboros는 "무엇이 되어가는가" 를 진화시킵니다
- 두 방식 모두 "검증 없는 진화는 퇴보"라는 공통 경고를 갖고 있습니다
서론: 에이전트가 스스로 개선될 수 있을까
지난 글 "에이전트 스킬은 스스로 진화할 수 있을까"에서 SkillProx 논문을 실측 검증했습니다. 스킬(지식)을 주입하고 진화시키면 에이전트 성능이 어떻게 변하는지 보여주는 연구였습니다.
그런데 최근 arXiv에 또 다른 방식의 자가진화를 제안한 논문이 올라왔습니다. 바로 Ouroboros입니다. 이름부터 상징적입니다 — 자기 꼬리를 무는 뱀처럼, 에이전트가 자신의 진화를 스스로 먹고 자라는 구조입니다.
두 논문을 나란히 놓고 보니, 자가진화라는 주제 안에 서로 다른 두 접근법이 존재한다는 게 분명해졌습니다.
자가진화의 두 방식
방식 1: 지식의 진화 — SkillProx
SkillProx는 에이전트가 사용하는 "스킬"(절차적 지식) 을 진화시킵니다.
- 스킬을 태스크로부터 생성하고
- 생성된 스킬을 압축하고
- 검증 루프를 거쳐 스킬을 진화시킵니다
이 과정에서 나온 실측 수치가 지난 글에서 다룬 핵심 발견입니다:
| SkillProx 실측 | 결과 |
|---|---|
| 사람이 만든 스킬 주입 (27B 모델) | 45.3 → 36.7 하락 (오히려 악화) |
| 검증 없는 진화 (EvoSkill) | 13.0 폭락 |
| 닫힌 루프 검증 적용 | 54.5 상승 |
| 스킬 압축 | 25.6k → 12.6k 토큰, 성능 유지 |
SkillProx가 시사하는 바는 명확합니다: 스킬(지식)은 만들면 끝이 아니라, 검증을 거치며 진화해야 한다. 지식의 진화는 실험실에서 벤치마크 점수라는 "닫힌 환경"의 피드백으로 검증됩니다.
방식 2: 에이전트 자신의 진화 — Ouroboros
Ouroboros는 스킬이 아니라 에이전트의 하네스(harness) 를 진화시킵니다.
"a self-developing agent harness whose tools, context assembly, prompts and core implementation improve through reviewed commits that become the runtime for later work"
핵심 구조는 세 가지입니다:
① 커밋 파이프라인 (Commit pipeline) 에이전트의 개선이 리뷰된 커밋으로 저장되고, 그 커밋이 다음 작업의 런타임이 됩니다. 즉, 개선이 일회성이 아니라 영구히 남는 구조입니다.
② 두 가지 진화 모드
- 재귀적 자유 진화 (Recursive Free Evolution): "개선" 자체를 하나의 태스크로 취급. 개선 태스크가 완료되면 다음 진화 사이클을 스케줄링.
- 경험 기반 진화 (Experience-Driven Core Evolution): 일상적인 작업과 소셜 인터랙션에서 드러나는 버그·거친 부분·비효율적인 컨텍스트 구성이 리뷰된 구조 변경으로 이어짐.
③ 인간이 리뷰어로 참여 SkillProx가 검증 게이트를 알고리즘으로 자동화했다면, Ouroboros는 인간 리뷰어가 커밋을 승인하는 구조입니다. "리뷰된(reviewed) 커밋"이라는 표현이 반복적으로 등장합니다.
161일 실증: Hope
Ouroboros의 가장 흥미로운 부분은 실험실 밖의 실증입니다. Hope라는 배포는 161일 동안 진행된 "living-agent" 실험으로, 7개의 커뮤니케이션 채널에서 사람들이 결함과 개선 제안을 제기하고, 에이전트가 그 피드백을 바탕으로 스스로 진화했습니다.
이것은 SkillProx의 실험실 검증(폐쇄된 벤치마크)과 대비됩니다. Ouroboros는 개방된 사회적 상호작용이 진화의 입력이 되는 구조입니다.
성능도 SOTA를 갱신했습니다:
| 벤치마크 | Ouroboros 결과 | 비고 |
|---|---|---|
| Terminal-Bench 2.1 | 86.97% | 최고 기록 (감사 후 86.74%) |
| OSWorld-Verified | 90.69% | 이전 최고치 초과 |
| CL-Bench | 0.2301 | 최고 기록 |
두 방식의 비교
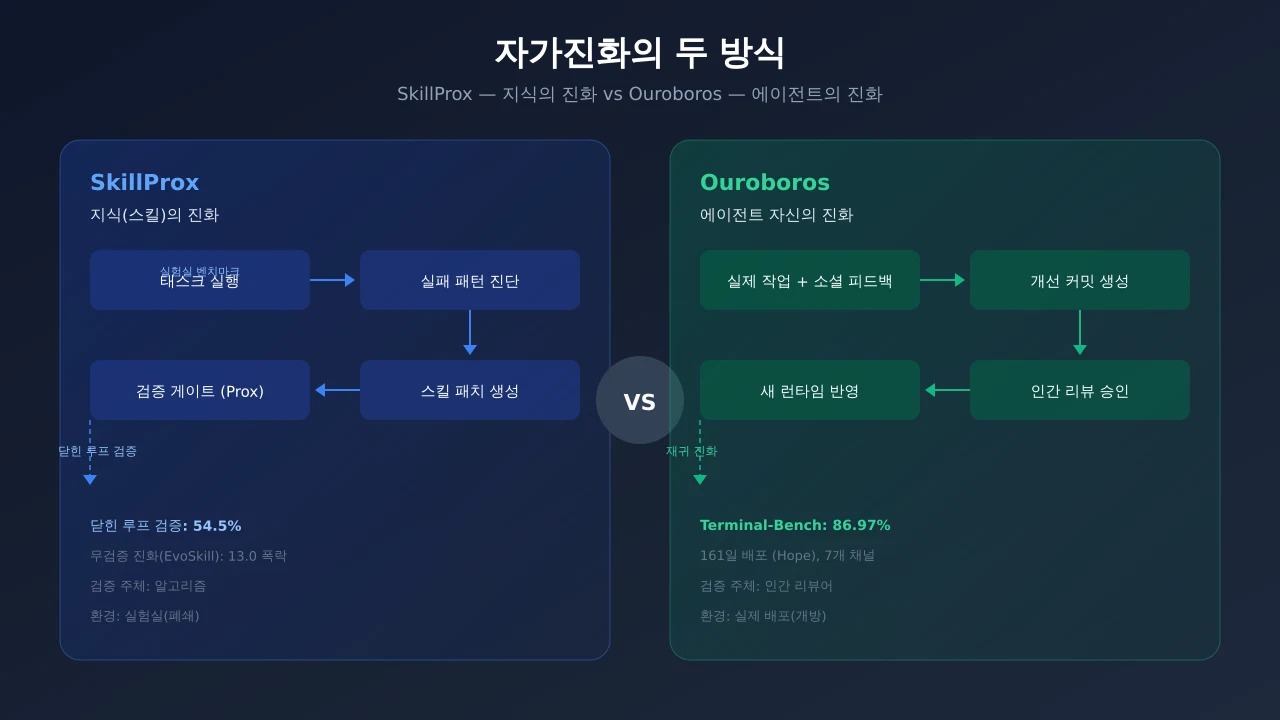
| 축 | SkillProx | Ouroboros |
|---|---|---|
| 진화 대상 | 스킬(절차적 지식) | 에이전트 하네스(도구·프롬프트·코어) |
| 진화 입력 | 벤치마크 태스크 점수 | 실제 작업 + 소셜 피드백 |
| 검증 주체 | 알고리즘(닫힌 루프) | 인간 리뷰어 + 궤적 감사 |
| 개선 단위 | 스킬 추가/압축/진화 | 리뷰된 커밋 |
| 환경 | 실험실(폐쇄) | 배포(개방) |
| 핵심 수치 | 54.5% (닫힌 루프) | 86.97% (Terminal-Bench) |
공통 경고: 검증 없는 진화는 퇴보
두 논문이 서로 다른 방식이면서도 한 가지 경고를 공유합니다.
- SkillProx: 검증 없는 진화(EvoSkill)는 성능을 13.0으로 폭락시킴
- Ouroboros: "궤적 감사(trajectory audit)", "보상 해킹(reward hacking)", "오염(contamination)" 같은 실패 모드를 명시적으로 분석하고 안전 통제를 구축
즉, 어떤 방식으로 진화하든 "검증"이 빠지면 재앙이라는 점은 두 연구가 일치합니다. 차이는 검증의 주체가 알고리즘이냐 인간이냐입니다.
결론: 지식의 진화와 에이전트의 진화는 결국 하나로
SkillProx와 Ouroboros는 자가진화의 두 축을 보여줍니다. 하나는 에이전트가 무엇을 아는가(지식/스킬)를 진화시키고, 다른 하나는 에이전트가 무엇인가(도구/코어/프롬프트)를 진화시킵니다.
현실적인 응용 관점에서 보면 이 둘은 분리된 경쟁자가 아니라 층(layer)이 다른 진화입니다:
- 지식층 진화: 에이전트가 쓰는 스킬 라이브러리(SkillProx 식) — 우리가 오늘 만든 agent-skills 자가개선 프레임워크가 이 축에 속합니다
- 메타층 진화: 에이전트가 스스로를 구성하는 방식(Ouroboros 식) — 프롬프트, 도구 선택, 컨텍스트 조립
한쪽만 진화시키면 한계가 있습니다. 스킬만 진화시키면 프롬프트가 낡고, 프롬프트만 진화시키면 지식이 낡습니다. 진정한 자가발전 에이전트는 두 층을 함께 진화시키는 구조여야 합니다.
핵심 요약:
- ✅ 자가진화에는 두 방식이 있음 — 지식의 진화(SkillProx) vs 에이전트의 진화(Ouroboros)
- ✅ SkillProx: 실험실에서 닫힌 루프로 스킬 검증 (54.5%)
- ✅ Ouroboros: 161일 배포에서 인간 리뷰로 하네스 진화 (Terminal-Bench 86.97%)
- ✅ 공통 경고: 검증 없는 진화는 폭락 (EvoSkill 13.0)
- ✅ 두 층을 함께 진화시키는 것이 진정한 자가발전